Por Camila Clunes · BT Biotecnóloga · Bioquimica.cl
Toda la diversidad biológica y las funciones celulares de un organismo están codificadas en secuencias compuestas por cuatro bases nitrogenadas: Adenina (A), Timina (T), Citosina (C) y Guanina (G). La secuenciación es un estrategia que se utiliza para determinar el orden exacto de estas bases en una hebra de ADN. A lo largo de las últimas cinco décadas, la tecnología para descifrar este código ha evolucionado radicalmente.
Anteriormente, se requería meses para leer unas pocas docenas de bases, hoy es posible realizarlo en tiempo real alcanzando la lectura de genomas completos. Es importante conocer las características de cada generación de secuenciación para seleccionar la estrategia que sea más adecuada para cada tipo de proyecto.
En 1977 Frederick Sanger desarrolló la secuenciación por terminación de cadena, marcando así el inicio de la era genómica. El método funciona simulando la construcción natural del ADN en el laboratorio. Durante la reacción, la enzima encargada de ensamblar la cadena utiliza nucleótidos normales para avanzar, mezclados con una pequeña proporción denucleótidos modificados que detienen la elongación y están marcados con moléculas químicas llamadas “fluoróforos”, las cuales se adhieren químicamente a cada una de las 4 bases del ADN modificadas (los ddNTPs).
Cuando la enzima incorpora por azar uno de estos nucleótidos modificados, la construcción se detiene de inmediato. Esto genera miles de fragmentos de ADN de diferentes tamaños, donde cada uno termina en una base con una etiqueta de fluorescencia específica. Finalmente, estos fragmentos son ordenados de menor a mayor según su peso molecular a través de una electroforesis capilar, permitiendo que un láser detecte la señal emitida que permite revelar la secuencia exacta.
Cada tipo de base, emite luz en una frecuencia que es interpretada con un color diferente cuando el láser la ilumina:
A mediados de la década del 2000, la secuenciación de siguiente generación (NGS, por sus siglas en inglés) cambió por completo la forma de secuenciar, permitiendo leer millones de fragmentos de ADN al mismo tiempo, reduciendo drásticamente los costos y tiempos de trabajo. La muestra de ADN se fragmenta en trozos pequeños, a los cuales se les ligan adaptadores específicos. Estos fragmentos se amplifican clonalmente en una superficie sólida y se secuencian simultáneamente mediante reacciones cíclicas de síntesis con nucleótidos fluorescentes.
Un sistema óptico toma imágenes de alta resolución en cada ciclo para determinar la base incorporada en millones de clusters en paralelo.
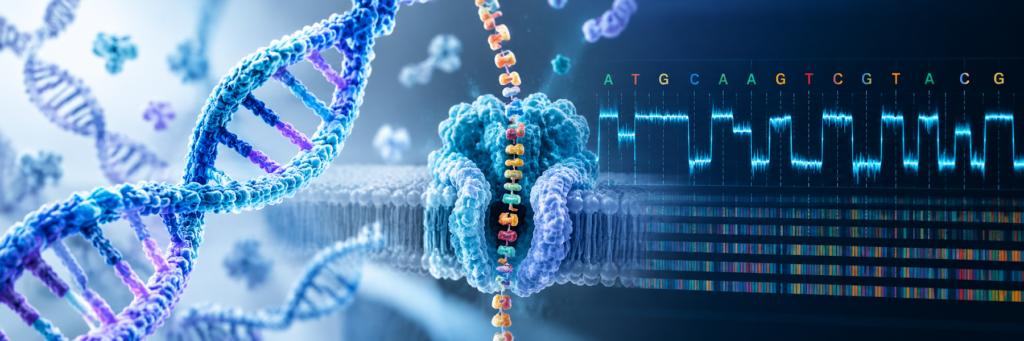
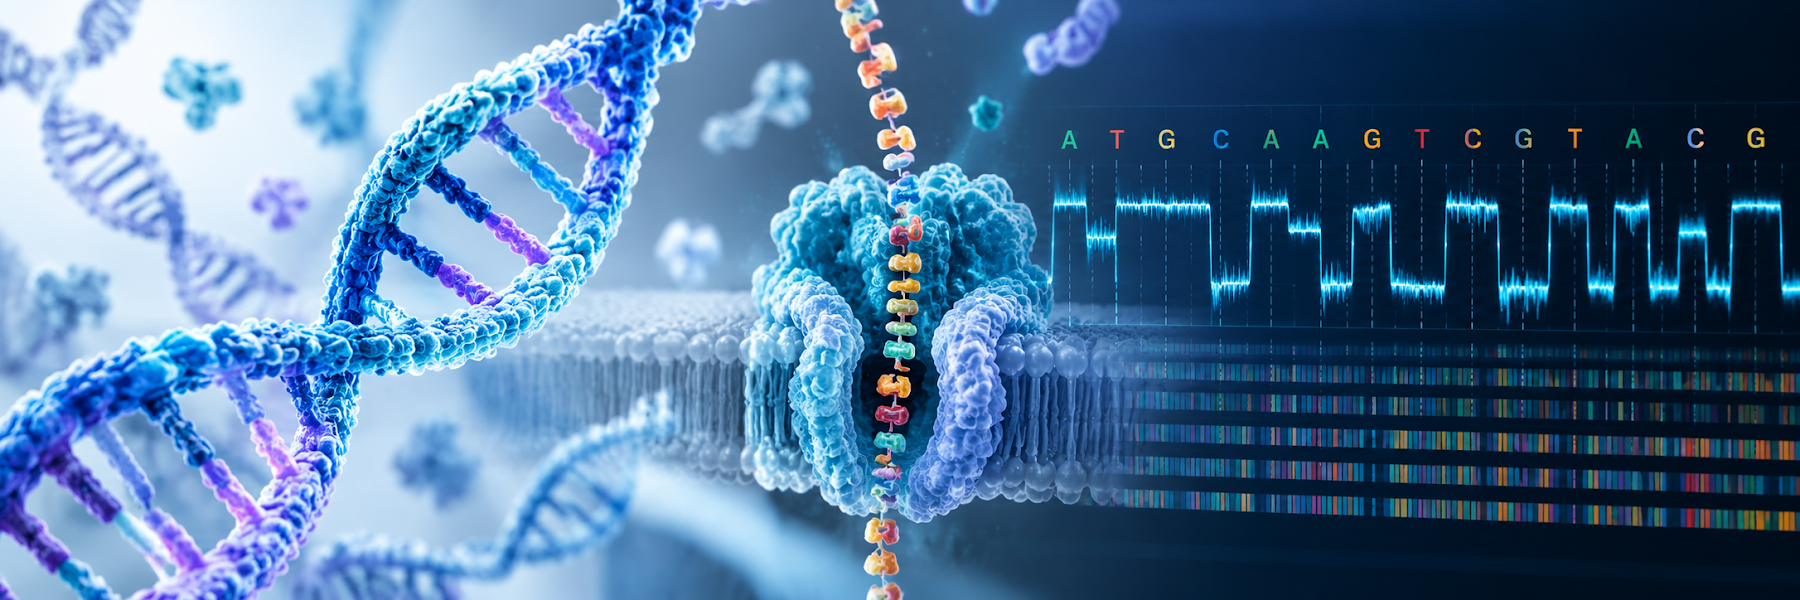
La necesidad de resolver las zonas complejas del genoma impulsó el desarrollo de metodologías capaces de leer moléculas individuales de ADN o RNA continuo sin fragmentación previa. Principio técnico (Enfoque Oxford Nanopore) A diferencia de los métodos ópticos o químicos de síntesis, la secuenciación por nanoporos utiliza un mecanismo electrofísico directo. Una hebra única de ADN o RNA nativo pasa a través de un poro proteico nanométrico embebido en una membrana sintética resistente a la corriente.
El paso de los nucleótidos interrumpe el flujo eléctrico de forma característica para cada base. Un algoritmo basado en aprendizaje profundo traduce esas variaciones eléctricas a la secuencia de bases en tiempo real.
| Parámetro | Primera generación · Sanger | Segunda generación · NGS | Tercera generación · Nanopore |
|---|---|---|---|
| Tipo de lectura | Lectura corta individual | Lecturas cortas en paralelo | Lecturas largas continuas (short to ultra-long) |
| Longitud típica | 500–1.000 pb | 75–300 pb | De miles a millones de pb |
| Detección de metilación | Requiere tratamiento previo | Requiere conversión por bisulfito | Detección directa en molécula nativa |
| Tiempo de respuesta | Horas (muestras puntuales) | Días (espera al término del ciclo) | Minutos / tiempo real |
| Punto fuerte | Verificación puntual | Variantes simples (SNV) a escala | Variantes estructurales y genomas complejos |
Ninguna tecnología de secuenciación invalida a las demás; cada una responde a preguntas biológicas y escalas distintas. Mientras que la secuenciación Sanger sigue siendo el estándar de oro para confirmar variantes puntuales aisladas y la NGS domina en análisis masivos donde las lecturas cortas son suficientes, la secuenciación por nanoporos de tercera generación resuelve los puntos ciegos históricos del genoma, aportando flexibilidad, lectura continua y resultados en tiempo real.
Llévate el contenido completo en PDF para consultar y compartir con tu comunidad.
Podemos asesorarte en la elección de equipos y materiales para tus actividades.